Viele Unternehmen verfügen über umfangreiche Datenbestände, doch ihren KI-Systemen fehlt häufig der notwendige geschäftliche Kontext. Besonders problematisch ist Wissen, das ausschließlich in den Köpfen einzelner Mitarbeitender existiert. Context Engineering soll dieses Wissen systematisch erschließen und über eine semantische Schicht für KI-Agenten verfügbar machen. Dafür sind neben geeigneten Technologien auch organisatorische Veränderungen erforderlich.
Der produktive Einsatz künstlicher Intelligenz scheitert in Unternehmen häufig nicht an der Leistungsfähigkeit der eingesetzten Modelle, sondern an fehlendem Kontext. Einer Untersuchung von Harvard Business Review Analytic Services im Auftrag von Cloudera zufolge halten lediglich sieben Prozent der befragten Unternehmen ihre Daten für vollständig KI-bereit. Besonders bei KI-Agenten, die eigenständig Informationen verarbeiten und Aufgaben ausführen sollen, wird fehlendes Geschäftswissen zum Problem.
Wie der Datenplattformanbieter Starburst erläutert, sind die benötigten Informationen häufig bereits im Unternehmen vorhanden, für KI-Systeme jedoch nicht zugänglich. Laut einer Studie von Deloitte sehen 48 Prozent der Unternehmen die mangelnde Durchsuchbarkeit ihrer Daten als Hindernis für die KI-Automatisierung. Weitere 47 Prozent nennen die fehlende Wiederverwendbarkeit von Daten.
Dabei unterscheidet Starburst zwei grundlegende Herausforderungen: Informationen, die zwar gespeichert, aber technisch nicht erreichbar sind, und geschäftliches Wissen, das bislang überhaupt nicht dokumentiert wurde. Während sich Datensilos durch geeignete Schnittstellen und Datenplattformen erschließen lassen, ist der Umgang mit implizitem Wissen deutlich komplexer.
Implizites Wissen wird zum Hindernis für KI-Agenten
In vielen Unternehmen beruhen Kennzahlen, Berechnungen und Geschäftsprozesse auf Erfahrungen einzelner Mitarbeitender. Welche Datenquelle für eine bestimmte Auswertung maßgeblich ist oder nach welchen Regeln Kennzahlen berechnet werden, wurde dabei nicht immer schriftlich festgehalten.
Für menschliche Teams funktioniert dieses Vorgehen häufig über persönliche Abstimmungen und gewachsene Zuständigkeiten. KI-Agenten fehlt dagegen die Möglichkeit, solche Zusammenhänge ohne entsprechende Dokumentation zuverlässig nachzuvollziehen.
Das kann zu fehlerhaften Ergebnissen führen. Liegen beispielsweise unterschiedliche Umsatzwerte aus mehreren Datenquellen vor, benötigt ein KI-System verbindliche Regeln, um den korrekten Wert auszuwählen. Fehlen diese, kann es veraltete Informationen verwenden oder Angaben erzeugen, die zwar plausibel erscheinen, aber sachlich falsch sind.
Auch leistungsfähige Sprachmodelle können diese Lücke nicht eigenständig schließen. Sie können vorhandene Informationen auswerten und zusammenfassen, aber nicht ohne verlässliche Grundlage bestimmen, welche unternehmensspezifischen Regeln tatsächlich gelten.
Context Engineering schafft eine verbindliche Wissensgrundlage
Hier setzt Context Engineering an. Der Ansatz verfolgt das Ziel, geschäftliche Zusammenhänge systematisch zu erfassen, aufzubereiten und KI-Anwendungen bereitzustellen. Im Mittelpunkt steht damit nicht die nachträgliche Korrektur von KI-Ergebnissen, sondern die Qualität und Vollständigkeit der Informationen, die den Systemen zur Verfügung stehen.
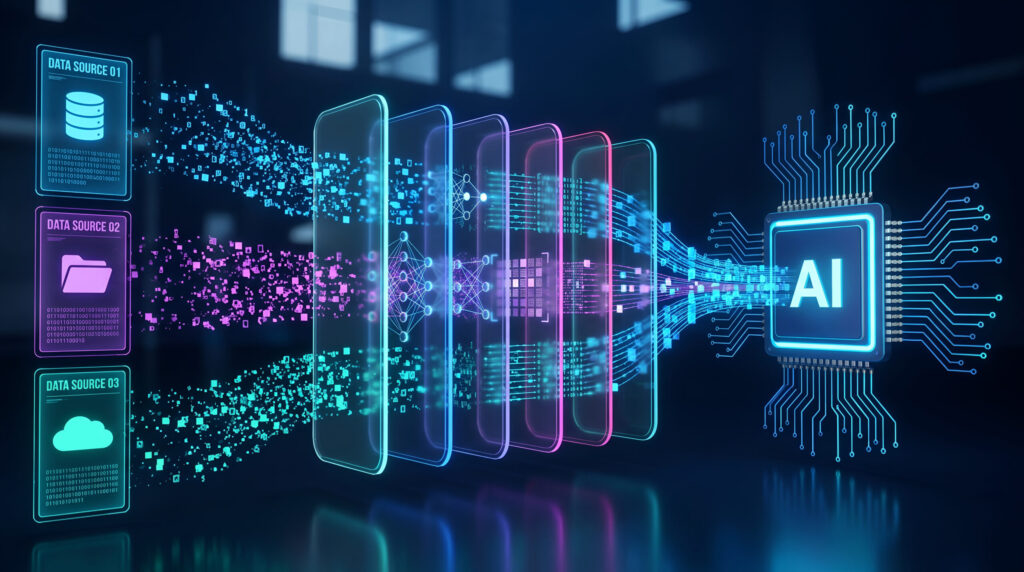
Eine zentrale Rolle übernimmt dabei die semantische Schicht. Sie verbindet technische Datenstrukturen mit ihrer geschäftlichen Bedeutung und stellt beispielsweise Definitionen, Berechnungsregeln und Zusammenhänge für Anwendungen und KI-Agenten bereit.
Für ihren Aufbau sind nach Einschätzung von Starburst zwei Maßnahmen entscheidend: der unternehmensweite Zugriff auf vorhandene Daten und die systematische Dokumentation bislang nicht erfassten Wissens.
Beim Datenzugriff können föderierte Architekturen helfen. Statt Informationen aus unterschiedlichen Systemen vollständig in eine zentrale Umgebung zu migrieren, ermöglichen sie Abfragen über mehrere Datenquellen hinweg. KI-Agenten können dadurch beispielsweise auf Data Warehouses und Data Lakehouses zugreifen, ohne dass sämtliche Datenbestände zuvor verschoben werden müssen.
Für Datensätze mit besonderen Anforderungen an Performance oder Governance beschreibt Starburst zudem die Möglichkeit, diese gezielt in ein auf Apache Iceberg basierendes Data Lakehouse zu überführen.
Unternehmen müssen Wissen dauerhaft dokumentieren
Die technische Integration allein reicht allerdings nicht aus. Unternehmen müssen zusätzlich herausfinden, an welchen Stellen geschäftlicher Kontext fehlt und welche Fachleute über das entsprechende Wissen verfügen.
Dazu gehört, bestehende Definitionen und Entscheidungsregeln nachvollziehbar festzuhalten und in die semantische Schicht einzubinden. Ebenso wichtig sind Prozesse, mit denen neue Erkenntnisse und veränderte Geschäftsregeln kontinuierlich dokumentiert werden.
Damit wird Context Engineering auch zu einer organisatorischen Aufgabe. Fachabteilungen und IT müssen gemeinsam sicherstellen, dass geschäftliches Wissen nicht ausschließlich an einzelne Personen gebunden bleibt.
Für den produktiven KI-Einsatz ergibt sich daraus eine grundlegende Anforderung: Unternehmen benötigen nicht nur leistungsfähige Modelle und zugängliche Daten, sondern auch eine verlässliche Grundlage für deren Interpretation. Erst wenn technische Informationen und geschäftlicher Kontext zusammengeführt werden, können KI-Agenten Ergebnisse liefern, die sich im Unternehmensalltag nachvollziehen und zuverlässig nutzen lassen.